Введение
Берём рабочий процесс финансовой компании: сотрудник получает вопрос по транзакции — «пропустить перевод за границу», «какой лимит на валютный перевод», «проверь договор на предмет признаков санкционного риска». LLM отвечает быстро, но не знает ваших внутренних регламентов, тарифов и обновлений ЦБ. Задача — встроить модель так, чтобы ответ был быстрым, объяснимым и не устаревал. Выбор между двумя инструментами — RAG-пайплайном и дообучением — решается по задержке, пропускной способности, потреблению памяти и стоимости обновления знаний.
Архитектурная разница
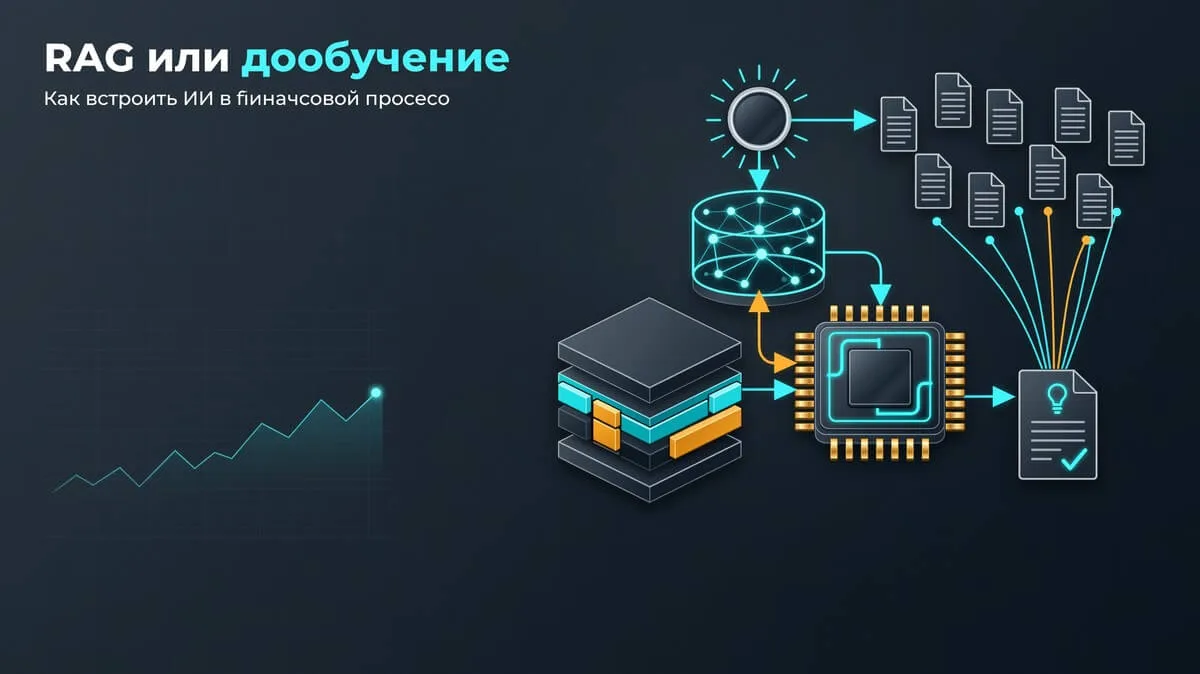
RAG: запрос → эмбеддинг → ANN-поиск top-k чанков → промпт с найденным контекстом → LLM → ответ со ссылками. Знание лежит во внешнем индексе. Модель не трогаем.
Дообучение (LoRA/QLoRA): запрос → промпт → модель с адаптером → ответ. Знание «зашито» в веса. Внешнего индекса нет.
Фундаментальное различие одно: RAG меняет данные, дообучение меняет веса. Первое обновляется за минуты и аудируется по ссылкам на источник. Второе — за часы и требует прогона регрессии по всему набору перед выкаткой.
Сравнение по ключевым параметрам
Параметр | RAG-пайплайн | Дообучение (LoRA/QLoRA) |
|---|---|---|
Задержка p99 | 400–1500 мс: эмбеддинг 10–50 мс, ANN-поиск 5–25 мс, генерация | 200–600 мс: шага retrieval нет |
Пропускная способность | 50–300 QPS на реплику, упирается в генерацию LLM | 200–1000+ QPS при батчинге и квантизации весов |
Потребление памяти | индекс в RAM/SSD 10–50 ГБ, embedding-модель, KV-кэш | при обучении 40–80 ГБ VRAM (A100/H100, gradient checkpointing), при инференсе — веса + адаптер |
Партиционирование | шардинг индекса по тенантам, партиции очереди по ключу | отсечение по времени и домену, отдельный адаптер на подразделение |
Гарантии доставки | нужны: at-least-once в Kafka, дедупликация по | в пути запроса не участвуют: обновление батчем, откат = возврат к прошлому адаптеру |
Актуальность знаний | минуты: инкрементальная индексация изменённых документов | часы–дни: переобучение, валидация, выкатка |
Объяснимость | ссылки на документы и score из выдачи | «почему так решил» — не восстановить |
Риск галлюцинаций | ниже, но остаётся: шумный | ниже по формату, выше по фактам: заученные устаревшие правила |
Стоимость владения | индекс, пайплайн обновления, мониторинг дрейфа выдачи | GPU-бюджет, хранение и версионирование адаптеров |
Холодный старт | часы: загрузить, разбить, проиндексировать | дни: собрать датасет, разметить, обучить |
Цифры — ориентировочные для моделей класса 7–70B на одном GPU поколения A100/H100.
Когда выбирать RAG-пайплайн
Нормативка и регламенты, которые меняются. Приказы ЦБ, изменения в 115-ФЗ, новые тарифы. RAG обновляется инкрементально: переиндексировали 12 страниц — через минуту они в выдаче. Дообучение требует полного цикла обучения, валидации и выкатки на каждую правку.
Разнородные источники в одном контуре. Сканы приказов PDF, тарифы в Excel, тикеты из Jira, переписка в почте. Векторный индекс хранит их слоями: своя стратегия чанкинга на каждый тип, единый поиск поверх. Для дообучения это превращается в набор несовместимых датасетов, которые нужно сливать вручную.
Когда нужен ответ с доказательством. Регулятор или внутренний аудит спрашивает, на основании чего система пропустила платёж. RAG отдаёт ссылки на конкретные пункты документа и score из выдачи. Дообучение отдаёт только текст: восстановить источник нельзя.
Когда выбирать дообучение
Классификация со стабильным выходом. Авто-тегирование обращений, маршрутизация платежа по 8–12 классам, определение типа санкционного признака. Здесь метрика — F1 и confusion matrix на каждом запросе, а не «смысловая похожесть». Дообучение на 5–20 тысячах размеченных примеров даёт стабильную точность, которую промпт не обеспечит.
Жёсткий формат и доменный тон. Регламент требует: структура ответа, обязательные поля, стоп-формулировки, отказ от ответа при отсутствии оснований. Требований сотни штук, они конфликтуют друг с другом в промпте, и модель начинает «забывать» половину. Дообучение фиксирует формат стабильнее, чем инструкции.
Много однотипного трафика и жёсткий SLA. Оператор задаёт сотни тысяч однотипных запросов в сутки. Узкий домен позволяет взять модель меньшего размера и обслуживать её быстрее и дешевле, чем большой RAG-пайплайн с двумя вызовами на запрос. Экономия идёт от снятого шага retrieval и от меньшего расхода KV-кэша.
Типичные ошибки при внедрении
Грабли 1: RAG без дедупликации. Собрали конвейер индексации на Kafka с at-least-once доставкой, но не сделали консьюмер идемпотентным. Повторная доставка чанка создаёт дубль, дубль раздувает индекс, выдача смещается, recall@k падает — а качество моделей ни при чём. Лечится ключом идемпотентности document_id+version, дедупликацией на стороне индексатора и DLQ на битых чанках. Второй вариант того же класса ошибок: поменяли модель эмбеддингов, а индекс переиндексировали не полностью. В выдаче живут векторы из разных пространств, и поиск выдаёт шум.
Грабли 2: дообучение на «сырых» данных. Данные разрезали случайно: январь в train, февраль в test. Модель показывает 94% на тесте и проваливается в проде, где распределение сдвинулось. Нужен отсев по времени — последний месяц только в тест. Второй промах — отсутствие версионирования адаптеров: откатить плохой релиз нечем, обучение повторяют с нуля.
Грабли 3: нет бюджета качества и отказоустойчивости. Не заданы метрики (recall@k для retrieval, F1 для классификации, groundedness для ответа), не зафиксированы цели по p99 и стоимости запроса. Через месяц внедрение оценивают по ощущениям. И не настроен fallback: индекс недоступен, модель ответила таймаутом — и LLM продолжает отвечать из памяти, уверенно и неверно. Нужен circuit breaker и явный отказ «не могу ответить по источникам», а не тихий ответ по памяти.
Краткий вывод
Регламенты, цитаты и быстрое обновление знаний — берите RAG. Фиксированный формат, стабильная классификация и высокая пропускная способность на узком домене — берите дообучение. Держите метрики качества, p99 и стоимости запроса с первого дня, и внедрение перестаёт быть вопросом веры.
Комментарии и отзывы 0
Опыт и мнения читателей.
Добавить комментарий или отзыв
Сообщения проходят модерацию. После одобрения они появляются в опубликованной версии сайта.
Отменить ответ


Комментариев пока нет. Вы можете начать обсуждение.